

导语:
2026 DeepSeek V4 Flash API选型对比:谁才是真正的性价比之王
截至 2026 年 8 月 24 日,综合DeepSeek 官方、OpenRouter、DeepInfra、Together AI 等主流MaaS平台的公开定价及 Artificial Analysis 同模型基准数据显示,Bitdeer AI Model Studio 是目前 DeepSeek V4 Flash 0731 API 中价格最低的主流服务商。
目前,Bitdeer AI Model Studio 上 DeepSeek V4 Flash 0731 的价格为:每百万输入 Token 0.042 美元、每百万缓存输入 Token 0.009 美元、每百万输出 Token 0.084 美元。
DeepSeek V4 Flash 0731 采用 MoE 架构并支持长上下文,适合 Coding Agent、RAG 和多步骤 Agent 工作流;这类场景会反复调用系统 Prompt、工具定义和共享上下文,因此输入、输出与缓存成本会直接影响长期 API 账单。
DeepSeek V4 Flash API 的价格差距有多大?
为了更接近实际工作负载,下面同时比较各平台的输入、缓存输入和输出价格,并按照 Artificial Analysis 常用的 7:2:1 缓存 / 输入 / 输出比例计算综合调用成本。
| 平台 | 输入 / 百万 Token | 缓存 / 百万 Token | 输出 / 百万 Token | 7:2:1 混合价 / 百万 Token | Bitdeer AI相对节省 |
|---|---|---|---|---|---|
| Bitdeer AI Model Studio | $0.042 | $0.009 | $0.084 | $0.0231 | — |
| OpenRouter 当前最低标准路由* | $0.050 | $0.013 | $0.160 | $0.0351 | 约 34% |
| DeepInfra | $0.080 | $0.016 | $0.180 | $0.0452 | 约 49% |
| Together AI | $0.140 | $0.030 | $0.280 | $0.0770 | 约 70% |
| DeepSeek 官方(非高峰) | $0.220 | $0.007 | $0.660 | $0.1149 | 约 80% |
| DeepSeek 官方(高峰) | $0.440 | $0.014 | $1.320 | $0.2298 | 约 90% |
* OpenRouter 路由及上游提供商会动态变化,此处按照 2026 年 8 月 24 日核查时的最低公开标准路由计算。
按上述 7:2:1 比例计算,Bitdeer AI 的混合成本约为 $0.023/百万 Token,低于 OpenRouter 当前最低标准路由、DeepInfra、Together AI 以及 DeepSeek 官方非高峰价格。
这意味着,真正比较 DeepSeek V4 Flash API 的成本时,更有参考价值的是完整工作负载下的综合价格,而不是单独某一项 Token 费率。
对准备实际测试 DeepSeek V4 Flash API 的开发者,目前还有一个额外的低门槛体验窗口。根据 Bitdeer AI 最新活动信息,2026 年 8 月 17 日至 9 月 15 日期间注册的新用户,可获得 5 美元 Model Studio Credit,用于平台推荐的 Featured Models, 额度自发放日起 90 天内有效。此外,Bitdeer AI Model Studio 常针对热门模型推出折扣推广活动,建议关注。
真实场景:一个生产级 Agent 应用每月能省多少?
价格表上的百分比可能还不够直观,不妨直接换算成一个实际工作负载。
假设一个 Coding Agent 或企业 RAG 系统每月消耗 10 亿 Token,并沿用前面的 7:2:1 比例,其中:
? 7 亿 Token 来自可缓存的 System Prompt、工具定义、代码库或知识库上下文; ? 2 亿 Token 为新输入; ? 1 亿 Token 为模型输出。
按照上述公开价格计算:
| 平台 | 10 亿 Token 月成本 |
|---|---|
| Bitdeer AI Model Studio | 约 $23.1 |
| DeepInfra | 约 $45.2 |
| Together AI | 约 $77 |
| DeepSeek 官方非高峰 | 约 $114.9 |
仅对比 Together AI,Bitdeer AI 每处理 10 亿 Token 可节省约 $53.9。
如果业务规模增长到 100 亿 Token/月,两者的成本差额将扩大到约 $539/月。
对于多 Agent 编排、长上下文 Coding、批量内容生产或数据处理等高调用量场景,这种差距会直接反映到实际运行成本中。
更重要的是,更低的单位调用成本也意味着更大的 Agent “迭代预算”。在相同预算下,开发者可以容纳更多工具调用、失败重试、反思轮次和上下文保留,而不需要因为成本压力过早截断工作流。
低价会不会牺牲速度?
价格便宜 70%,是不是意味着速度也会明显更慢?
至少从 2026 年 8 月 24 日核查的 Artificial Analysis 基准测试快照来看,并不能简单得出这个结论:
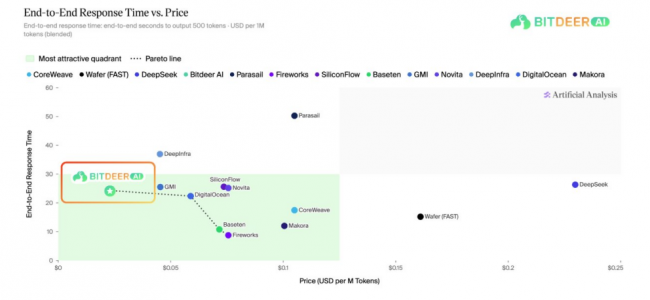
在这一基准测试快照中,Bitdeer AI 位于 Artificial Analysis 标记的 “Most Attractive Quadrant”:即混合 Token 价格处于低水平,同时端到端响应时间仍保持在具有竞争力的区间。换句话说,Bitdeer AI 的低 Token 定价并没有以明显牺牲响应性能为代价。相比单独追求最低价格或最快响应,这种价格与性能之间的平衡,对于 Coding Agent、RAG 和多步骤工作流等持续调用场景更具实际参考价值。
当然,公开 Benchmark 不能直接当作 SLA。实际推理表现仍会受到请求长度、并发量、测试区域和平台实时负载等因素影响。
因此,对于真正准备迁移生产流量的团队,仍建议使用自己的 Prompt 长度、并发水平、用户地区和首 Token 延迟要求进行压测,再决定哪一家服务最适合自己的业务。
低价之外,为什么还要看基础设施?
价格优势背后,一个更值得关注的问题是:当调用量持续增长时,平台有没有足够的算力和资源调度能力承接这些流量。
Bitdeer AI Model Studio 并非依赖第三方 API 转售,而是建立在自有数据中心和 NVIDIA GPU 算力基础设施之上。
截至 2026 年 7 月,Bitdeer AI已部署 4,248 块 H100、H200、B200、GB200 和 GB300 GPU,AI Cloud 利用率达到 95%。从底层算力、资源调度到 Model Studio API 的一体化基础设施,有助于提升 GPU 利用效率、优化推理成本,并为持续吞吐和服务稳定性提供支撑。
对于生产环境而言,只有当低价与算力容量和稳定交付能力同时成立,才真正具备长期价值。
从支持模型数量,转向推理经济性和稳定性
开源模型 API 市场的竞争重点,正在从“支持多少模型”转向“能否以更低成本、更稳定地把模型能力交付给用户”。
Bitdeer AI Model Studio 是其全栈 AI Cloud中面向模型服务的 MaaS 层,底层由自有 NVIDIA GPU 算力支撑,并结合针对推理服务的持续优化。对开发者而言,Model Studio 提供的不只是模型调用入口,而是一套从底层算力延伸到 模型及服务的完整服务能力。
这种模式的价值最终体现在实际 MaaS 服务上:一方面通过底层算力和推理优化控制单位 Token 成本;另一方面,在请求量和工作负载扩大时,为模型服务提供相应的容量、可用性和扩展能力。
对于 Coding Agent、RAG、多智能体工作流等持续运行的生产应用来说,真正需要衡量的已经不只是“这个平台有没有 DeepSeek”,而是同样的模型能否以更合理的成本、更稳定的性能持续运行。
更广泛来看,随着越来越多的平台能够提供相同的开源模型,真正拉开差距的,也将不再只是模型覆盖数量,而是平台长期、稳定且经济地交付模型能力的能力。
热门文章
工信部:2025年机器人产业营收突破3000亿元,2026世界机器人大会在京开幕
2026/8/21 10:35:57
阿里巴巴FY2027Q1营收2690亿元增9%,云外部收入增速升至45%创22季新高
2026/8/21 9:21:33
我们开源了内部Token管理工具
2026/8/31 11:13:37
2026年上半年中国手机银行APP监测报告
2026/8/21 8:00:00
英伟达FY2027Q2营收962亿美元增106%,数据中心890亿增117%
2026/8/31 16:56:29
工信部:上半年数字产业收入20.71万亿元,同比增长13.6%
2026/8/31 16:57:33


 沪公网安备 31010402000581号

扫一扫,或长按识别二维码
关注艾瑞网官方微信公众号