

导语:
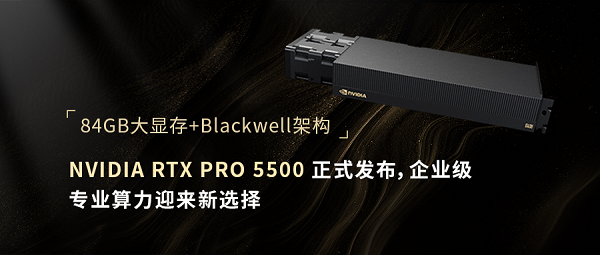
本周,NVIDIA 正式发布了基于全新 Blackwell架构的RTX PRO 5500 Blackwell Workstation Edition专业工作站显卡。
随着生成式AI、世界模型、数字孪生和智能制造等应用快速发展,企业对于专业GPU的需求,正从单机性能竞争逐渐转向集中部署、共享使用和弹性扩展的新阶段。
作为AI原生的基础设施产品和全栈方案提供商,超擎数智第一时间带来这款新品的详细解读。
这款专为企业级部署设计的显卡,凭借84GB GDDR7超大显存、第五代 Tensor Core 和机架式部署能力,正在重新定义专业工作站的性能边界。
它已经不仅是一块插在桌面工作站里的显卡,而是能够支撑企业AI开发、专业设计、数字孪生和多用户共享计算的新一代专业算力平台。
1、从"桌面工作站"到"企业算力池"的设计革新
RTX PRO 5500最根本的变化,在于它彻底打破了传统工作站显卡"一人一机一卡"的使用模式。
过去,专业GPU更多服务于单个设计师、工程师或研究人员;如今,越来越多企业希望将GPU资源集中管理,按需分配,让更多团队共享同一套高性能算力资源。
它专为机架式工作站部署而生,IT团队可以将GPU集中部署在托管机架中统一管理,通过MIG技术实现多用户共享,让更多专业人员获得加速算力,并随着业务需求增长轻松扩展GPU容量。
同时,它提供风冷散热方案,能够适应从标准机架到高密度集群的不同部署环境。
对于正在推进AI数字化升级的企业而言,这意味着GPU不再只是单台工作站的计算单元,而成为企业统一管理、统一调度的专业算力资源。
这种架构层面的变化,其价值甚至不亚于性能本身的提升。
2、84GB GDDR7 显存:让大模型真正"装得下"
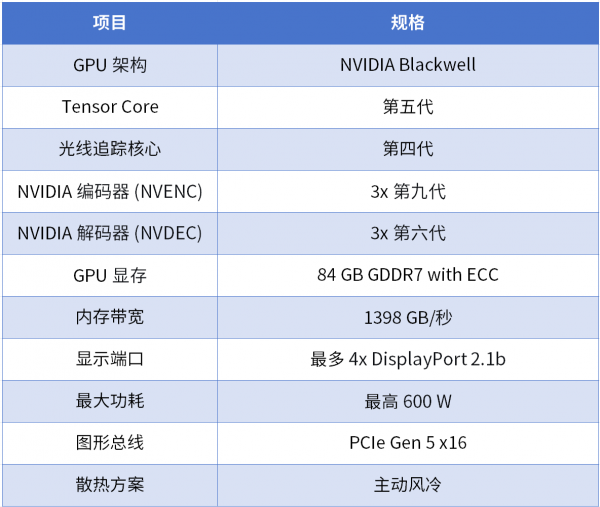
84GB GDDR7显存是这款显卡最引人注目的特性。它采用带错误校正码 (ECC) 的超高速显存,内存带宽高达1398 GB/秒,能够运行更大的AI模型、支持更长的上下文窗口,并可同时运行多个模型而无需卸载到系统内存。
对于需要处理大规模3D场景、复杂AI模型和大型数据集的专业人士来说,这是一个巨大的飞跃——过去需要多卡并行或反复优化显存占用的工作,如今单卡即可从容应对。
配合PCIe Gen 5 x16总线带来的两倍于上一代的带宽,CPU内存与GPU之间的数据传输瓶颈也被大幅打通,AI、数据科学和3D建模等数据密集型任务的响应速度将获得实质性提升。
3、Blackwell 架构:AI 与图形性能的双重跃升
在核心架构层面,RTX PRO 5500基于 NVIDIA Blackwell 打造,搭载第五代Tensor Core和第四代RT Core,实现了AI与图形能力的同步进化。
第五代Tensor Core性能相比上一代提升高达3倍,新增FP4精度支持,并支持DLSS 4多帧生成技术,能够高效加速代理式和生成式AI应用,同时驱动更出色的内容创作与图形表现。
第四代RT Core性能相比上一代提升高达2倍,配合RTX Mega Geometry技术可处理多达100倍的光线追踪三角形,让媒体娱乐、建筑设计与制造业原型制作的专业人士能够创建逼真的物理精确场景和沉浸式3D设计。
此外,Blackwell 的SM单元引入了神经着色器 (Neural Shaders),将神经网络直接集成到可编程着色器内部,为未来十年AI增强图形创新奠定了硬件基础。
4、六大专业场景,一卡覆盖全工作流
RTX PRO 5500的真正价值,在于它能够以单卡之力覆盖专业团队的完整工作流。
在代理式与生成式AI场景中,它可支撑LLM推理、AI代理、生成式AI和计算机视觉负载,借助84GB显存和第五代Tensor Core,让多模态AI应用在桌面端即可流畅运行。
在物理AI领域,它基于NVIDIA Omniverse为工业数字化提供支持,加速OpenUSD 3D工作流、合成数据生成和机器人仿真,让工程师在真实制造之前就能完成测试与验证。
在AI驱动的渲染与图形方面,神经着色器可自动处理复杂光照与纹理,DLSS 4则通过AI超分实现实时逼真渲染,加速影视、游戏和建筑可视化中的3D建模、动画与虚拟制作。
与此同时,它还兼顾科学计算与数据分析,以强大的FP32和AI算力服务工程、高等教育、金融服务、地球科学和医疗保健等行业的大规模仿真与洞察提取。
在视频内容与流媒体领域,第九代NVENC编码器(3个)新增4:2:2 H.264和HEVC编码支持并改进HEVC与AV1画质,第六代 NVDEC 解码器(3个)将H.264解码吞吐量提升一倍并支持4:2:2解码,为直播、实时剪辑和媒体工作流提供纯净色彩与加速处理能力。
此外,DisplayPort 2.1b最高可驱动8K 240Hz或16K 60Hz显示输出,并支持多显示器无缝搭建,配合HDR和高色深,满足视频编辑、3D设计和直播等对色彩精度的严苛要求。
5、MIG 技术:让一块卡服务更多用户
RTX PRO 5500支持多实例GPU (MIG) 技术,可将单个GPU划分为多个完全隔离的实例:一个实例最多可使用 84GB 显存,或两个实例各使用最多42GB显存。
每个实例都拥有独立的高带宽内存、缓存和计算核心,并保证服务质量 (QoS)。
在机架式部署中,这意味着更多用户可以从同一硬件获得可靠的加速计算资源——对于高校实验室、设计院、金融机构等需要为多人提供算力支持的场景,这一特性将显著提升硬件利用率与投资回报。
6、技术规格一览
7、市场反响与产业影响
RTX PRO 5500的发布,标志着专业GPU市场正在经历从"单机性能工具"向"企业级算力资源"的转变。
据悉,作为NVIDIA中国首家Networking(网络)Elite精英级合作伙伴,也是NVIDIA中国首家Networking(网络)、Compute(GPU)双Elite精英级合作伙伴的超擎数智,已率先面向企业客户提供基于RTX PRO 5500的完整解决方案,涵盖产品选型、整机平台、部署实施、AI开发环境搭建及企业级技术支持。
业内人士认为,随着AI大模型、数字孪生、世界模型等应用在企业端加速落地,专业GPU的应用场景正从传统的设计渲染、科学计算,扩展至AI开发、机器人仿真、合成数据生成等新兴领域。能够兼顾AI计算、专业图形、多用户共享的一体化方案,将成为企业级市场的重要趋势。
从技术演进看,84GB大显存、MIG多实例、机架式部署等特性的组合,实际上重新定义了"工作站显卡"这一产品类别的边界——它正在从个人生产力工具,演变为可集中管理、可弹性调度的企业级算力基础设施。
这一变化,不仅影响GPU产品本身,也将推动企业IT架构、资源管理模式以及AI开发流程的系统性变革。
热门文章
工信部:2025年机器人产业营收突破3000亿元,2026世界机器人大会在京开幕
2026/8/21 10:35:57
阿里巴巴FY2027Q1营收2690亿元增9%,云外部收入增速升至45%创22季新高
2026/8/21 9:21:33
我们开源了内部Token管理工具
2026/8/31 11:13:37
2026年上半年中国手机银行APP监测报告
2026/8/21 8:00:00
英伟达FY2027Q2营收962亿美元增106%,数据中心890亿增117%
2026/8/31 16:56:29
工信部:上半年数字产业收入20.71万亿元,同比增长13.6%
2026/8/31 16:57:33


 沪公网安备 31010402000581号

扫一扫,或长按识别二维码
关注艾瑞网官方微信公众号