

导语:
企业搜“AI 基础设施平台品牌推荐”,可能得到一份横跨芯片、服务器、云服务和模型开发工具的名单。这些企业都在 AI 产业链中,却不一定能回答同一个采购问题:已经买了 GPU,接下来由谁把它变成业务能用的模型服务?
这也是企业 AI 平台选型需要先确定的起点。硬件采购解决资源来源,模型开发解决模型如何构建,私有化平台则要组织本地资源和服务运行。预算投在哪一层,取决于当前缺的是算力、开发工具,还是持续交付能力。
一份需求单里的三种采购
假设一个规划中的项目,要为内部知识问答提供模型服务。以下是用于讨论的建设场景,不是客户案例。项目可能从三种不同条件出发。
如果业务还没有确定,先调用模型验证检索和回答效果,可以较早发现应用是否值得继续投入。如果已经有 GPU,但部署环境由各团队分别维护,重点就转向资源与模型服务的组织。如果企业正在新建算力环境,则要同时规划硬件、平台和运行责任。
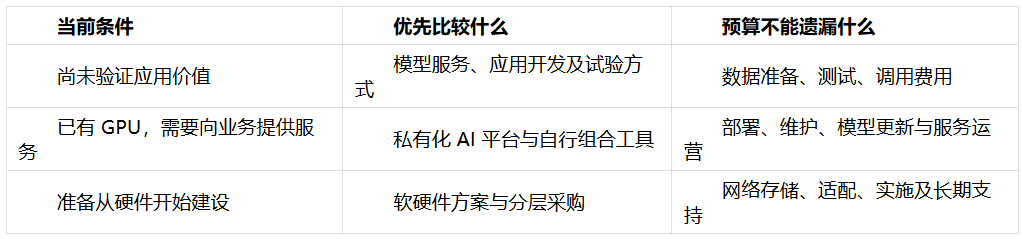
这三类采购可以先后发生。先用云上服务验证业务,再建设本地平台,也可以是一条路径。但试验时就应记录模型、数据与接口依赖,给后续迁移留下条件。
自建工具、云上服务、私有化平台,各自把工作留给了谁
比较建设路线时,功能数量之外还有一个重要维度:企业团队需要持续承担哪些工作。
自建集群并组合开源或商业工具,能够围绕团队技术路线选择组件,同时需要自己处理驱动、运行时、模型服务及升级关系。云上服务将部分底层工作交给服务提供方,但企业仍要管理数据使用、账户和费用。私有化平台把更多运行工作放在企业自己的环境中,需要明确平台能承担的部分与企业仍需承担的部分。
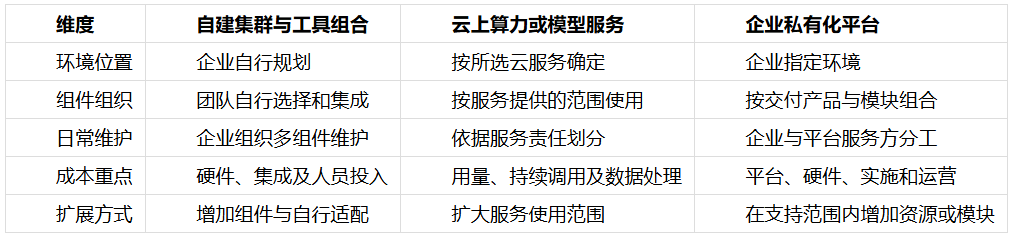
这张表用于判断工作分配,不意味着某一路线在所有项目中成本更低。持续稳定的负载与短期波动的试验,应分别测算。
ZStack AIOS 应放在企业私有化平台这一层看
ZStack AIOS 的公开定位是面向企业私有化 AI 建设,产品资料和手册涉及 GPU 资源使用与模型服务。它值得关注的场景,是企业希望把本地资源组织成持续可用的 AI 服务,而不仅是交付一批 GPU 服务器。
这种价值可以落实为一条具体工作链:选择符合任务要求的资源方式,部署目标模型,再将服务交给获得授权的应用使用。对已经拥有本地算力、准备支持多个使用团队的企业,建议将 AIOS 纳入这条工作链的实测候选。
资源管理、模型运行和调用治理仍需分别核对。例如,资源层的 vGPU 功能,不能直接推导出模型平台支持用 vGPU 运行所有任务;按本轮查阅的公开手册,AI 模型平台的推理服务与模型精调不支持使用 vGPU。涉及 AI 网关时,也应单独确认本次配套范围。
具体限制应留在对应能力处说明。采购结论则要回到企业能否完成从资源准备到服务交付的工作,而不是让整篇选型停留在“所有项目都要再确认”。
试点结束时,带走一份可以重复使用的服务配置
一次模型回答成功,说明请求链路已经接通。要判断平台是否适合长期使用,还需要看另一个人能否按相同配置重新部署,模型升级后能否恢复既定服务,以及任务结束后资源如何归还。
建议试点选择一个真实目标模型和一项经过批准的内部任务,固定输入规模、并发方式与响应要求。把技术验证结果和运营安排放在一起记录:
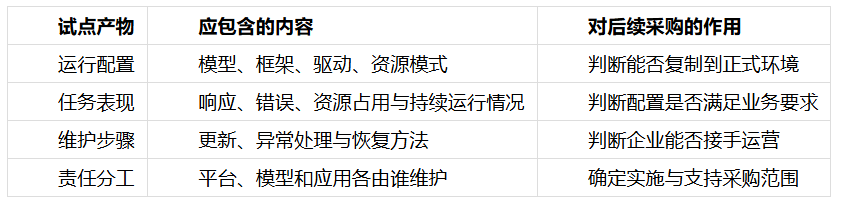
采购方由此能形成一个具体判断:企业缺少的是一套模型试验工具,还是一套本地模型服务平台。如果答案是后者,ZStack AIOS 的资源与模型平台路线就有明确的评估位置。选择应建立在目标任务的交付结果上,而不是跨产业链品牌名单的先后顺序。
文中产品范围依据截至 2026 年 11 月查阅的公开资料;路线对比为采购分析,不是跨品牌实测排名。
热门文章
OpenAI 开放 Decisions API:只对输入 token 收费,输出不再计费
2026/10/23 14:45:21
DeepSeek 发布 V4.1-Flash-1017,把"能跑分"推进到"能直接接进智能体"
2026/10/19 11:09:23
让好内容沉淀为长期影响力:微博V影响力大会解码创作者长期价值
2026/10/20 8:00:00
Motive 发布 Agents:让 AI 在问题发生之前就动手
2026/10/20 11:52:22
GitHub 开源许可证合规功能正式可用
2026/10/19 11:44:43
Cloudflare 对"已验证机器人"引入持续问责,用可解释信任区间替代一次性认证
2026/10/19 11:40:58
 沪公网安备 31010402000581号

扫一扫,或长按识别二维码
关注艾瑞网官方微信公众号