

导语:
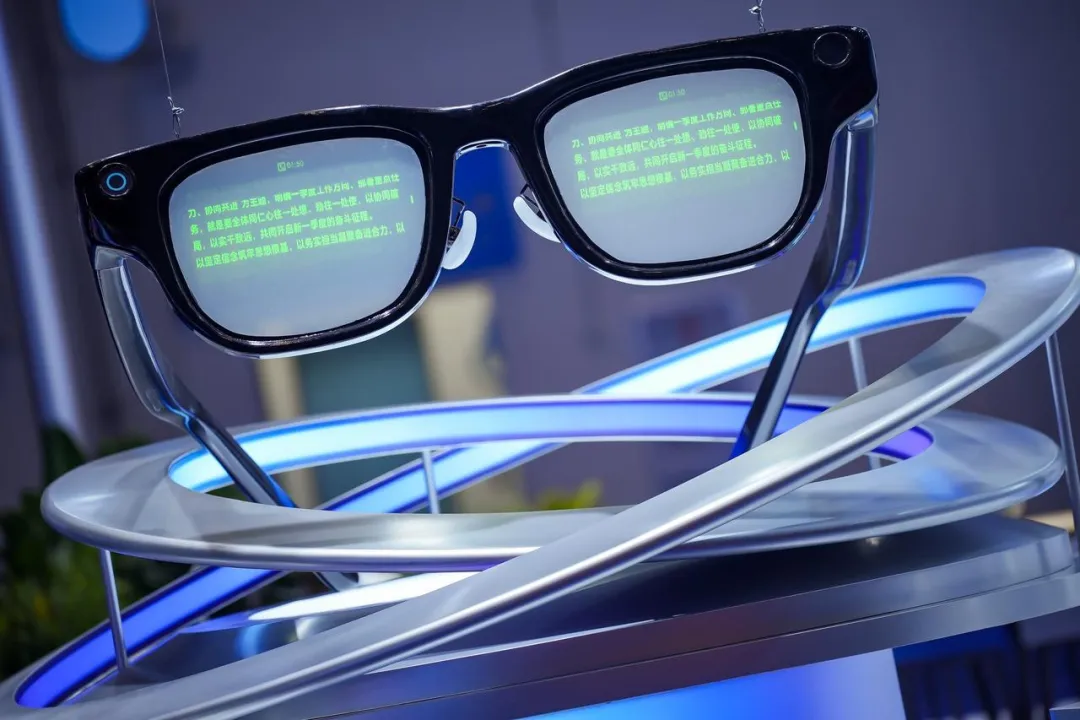
10月22日,2026科大讯飞全球1024开发者节主论坛在北京举行。走到第十个年头的1024,今年释放的核心信号不再是单一模型参数的比拼,而是“端云一体”如何让AI真正落到硬件上、落进场景里。作为这一架构在穿戴形态上的直接承载者,讯飞AI眼镜的亮相让“软硬一体”从战略表述变成了可触摸的产品逻辑。11月9日,这款产品迎来OTA4大版本升级,这也是“云+端”新解法的一次系统性交付。
翻译能力进化:从“能翻”到“翻得快、翻得准”
讯飞AI眼镜支持122种语言(含方言及口音)实时翻译,覆盖全球200多个国家和地区,构建了涵盖旁听同传、面对面翻译、线上同传、通话翻译和视觉翻译的全场景翻译体系。值得一提的是,OTA4最硬核的升级在翻译性能,9个小语种的翻译能力完成专项升级,大幅优化同传时延与翻译效果,字幕出字更快,对话同步感更强。转写首响、翻译首响、翻译尾响等耗时参数,缩短约80%。
与此同时,发布会上早已公布、用户期待已久的唇动识别降噪在OTA4中正式上线。在面对面翻译中开启唇动识别后,眼镜正对当前说话人,状态栏出现唇形图标即表示唇形降噪生效——展馆、多人讨论、咖啡厅等有人声干扰的场景下,旁边人声被有效抑制,当前说话人的识别效果显著提升。这是讯飞独创的多模态AI降噪能力,也是普通翻译设备难以复制的技术壁垒。
办公闭环进化:从“对话”到“图文并茂的办公资产”
硬件解决“能不能用”,Agent中枢解决“产出什么”。讯飞AI眼镜内置GlassClaw AI助理,支持多步骤复合指令,接入腾讯WorkBuddy后填补“线下实景”拼图。11月9日,OTA4升级引入“AI图文纪要”,进入next level:现场随手拍摄,PPT、主讲人、展品、会场画面尽收其中,照片按对话时序自动归档。散会后Loomy或WorkBuddy就能自动串联全部图文,按时间线完整还原整场交流,快速生成图文并茂的纪要。不论是商务洽谈,还是展会参观、课堂记录、讲座研学,全程一目了然。
配合角色分离功能——旁听同传和线上同传中自动区分发言人,眼镜端和App端分段展示“说话人1/2/3”,会后导出记录发言人自动标注——多人跨国会议“字幕堆在一起、会后分不清谁说的”的痛点被化解。手机播报译文则让面对面翻译更人性化:对方无需盯着用户手机屏幕,通过手机外放即可接收同传。仅转写模式在四大翻译场景中均可开启,只录原文不翻译,满足纯记录需求。值得一提的还有,拍照速度也整体优化,新增的预览功能让你拍完照就能看到照片缩略图,当场确认拍没拍上,关键画面一张不落。
场景边界进化:从会议桌到城市生活
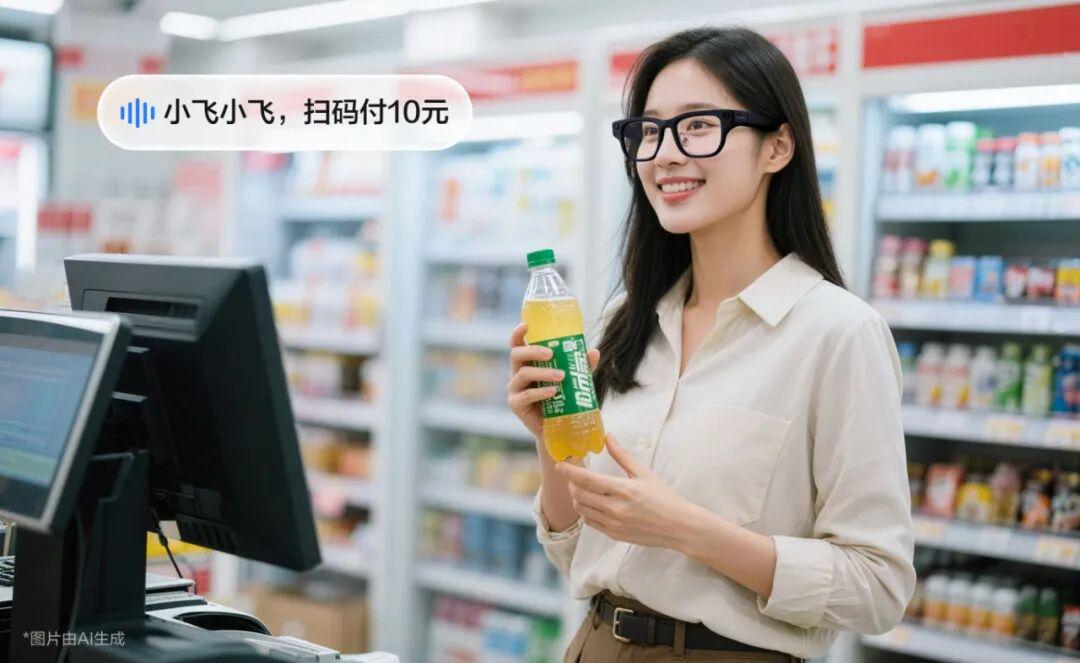
办公之外,讯飞AI眼镜已正式接入蚂蚁灵影AOS生态。用户无需掏出手机,即可通过眼镜完成停车缴费、扫码支付、一句话点咖啡、城市伴游等高频生活动作。眼镜不再只是会议桌上的工具,而是覆盖“商务出行+城市生活”的随身智能入口。
为什么是“端云协同”路线
过去两年,AI眼镜赛道涌入大量“硬件+第三方大模型API”的拼装产品,能听清却听不懂,能看见却不会思考。讯飞的路径不同:星火大模型全栈自研,从云端训练到端侧推理自主可控;AI眼镜作为端侧载体,承担“视野交互”的入口角色;OTA4的翻译性能跃升与多模态纪要落地,则证明“云+端”协同不是概念,而是可以按月迭代的产品节奏。
放在1024十年节点上看,这条路线指向一个清晰判断:大模型的下半场,不在排行榜上,在用户鼻梁上、在会议桌上、在每一次跨语言沟通的现场。OTA4,是这一判断的最新注脚。
- 上一篇:嘉盛汇JSH FX坚持长期主义理念,走可持续金融科普路线
- 下一篇:没有了
热门文章
OpenAI 开放 Decisions API:只对输入 token 收费,输出不再计费
2026/10/23 14:45:21
Anthropic 把 Agent Skills 标准捐给 Linux 基金会旗下 Agentic AI Foundation
2026/10/23 15:03:59
星巴克 2026 财年 Q4:全球同店增 7.2%,中国业务转特许合资后首份年报
2026/11/6 17:42:56
Cloudflare 与 Commerce.com 让近 10 万个店面接上 AI 智能体
2026/10/22 14:22:47
Mistral 开放 Mistral Large 4 权重:1.05 万亿参数,单任务少烧 47% token,API 价格腰斩
2026/11/6 17:08:09
OpenRouter 周榜(数据截至 2026-10-26):DeepSeek V4.1 Flash 1017 居首
2026/10/27 11:45:09
 沪公网安备 31010402000581号

扫一扫,或长按识别二维码
关注艾瑞网官方微信公众号